Platform Engineering · Multi-cloud Azure · AWS · GCP · Kafka · Databricks · Disponível para oportunidades enterprise

Eli
Rodrigues

Senior Data Engineer · Platform Architect · Modernização · Lakehouse · Databricks · PySpark · Delta Lake · dbt · Azure · AWS · GCP

Especialista em transformação e modernização de plataformas de dados — da identificação de limitações arquiteturais ao redesign completo em Lakehouse enterprise.

15+ anos construindo plataformas analíticas críticas com Azure Databricks, PySpark e Delta Lake, em ambientes regulatórios (BACEN) e projetos de IA aplicada.

Atuação hands-on com visão de arquitetura — governança, observabilidade, analytics readiness e AI-readiness como pilares de toda entrega.

Projeto autoral em dbt + Databricks — aprofundamento em transformações SQL e modelagem analítica, com código disponível no GitHub.

15+
Anos de experiência
3
Cloud Platforms
TB+
Dados processados

De FileStorage a Lakehouse Enterprise — Transformação de Plataforma

Identificação de limitações arquiteturais críticas em plataforma analítica legada baseada em FileStorage e condução do redesign completo para arquitetura Lakehouse moderna — governada, observável, escalável e pronta para Analytics & IA.

Diagnóstico arquitetural

A plataforma original utilizava FileStorage como camada primária de dados, sem controle transacional, sem versionamento, sem rastreabilidade de cargas e sem governança de acesso. Pipelines frágeis, ausência de mecanismos de replay e dados não estruturados bloqueavam o consumo analítico e inviabilizavam workloads de Machine Learning. A decisão foi não otimizar o legado — redesenhar a plataforma.

Estado anterior FileStorage Legacy
  • FileStorage como camada analítica primária — sem ACID
  • Sem versionamento nem time-travel dos dados
  • Pipelines sem replay handling ou deduplicação
  • Ausência de governança, RBAC e data lineage
  • Falhas silenciosas — nenhuma observabilidade operacional
  • BI e ML bloqueados por dados não estruturados para consumo
  • Sem semantic layer — cada time reconstruía sua lógica
Após modernização Lakehouse Enterprise
  • Arquitetura Medalhão Bronze/Silver/Gold com Delta Lake ACID
  • Time-travel, rollback e versionamento nativo
  • Replay handling, deduplicação e grain validation automáticos
  • Unity Catalog com RBAC, lineage e auditoria centralizada
  • Ingestion log + quality log + pipeline monitoring rastreável
  • Semantic layer analítica com views executivas para BI e ML
  • Orquestração DAG serverless ponta a ponta via Databricks Jobs

Fluxo arquitetural da plataforma modernizada

FileStorage
Legacy
legado
→
Ingestion
Layer
auditada
→
Bronze
Raw
dados brutos
→
Silver
Curated
qualidade validada
→
Gold
Semantic
semantic layer
→
Analytics
BI · ML · AI
consumo habilitado

6 capacidades enterprise entregues

Arquitetura Medalhão

Bronze → Silver → Gold com Delta Lake ACID. Separação clara entre dados brutos, curados e semânticos. Time-travel e rollback nativos em todas as camadas.

Governança Operacional

Unity Catalog com RBAC granular, data lineage automatizado, auditoria de cargas via ingestion_log e rastreabilidade end-to-end de cada execução.

Observabilidade de Pipelines

Quality log centralizado, pipeline execution monitoring, evidências operacionais documentadas e framework de troubleshooting para falhas rastreáveis.

Analytics Enablement

Semantic layer analítica com views executivas para BI. Datasets curados e padronizados, prontos para consumo direto por times de Data Science e Analytics.

AI-Ready Platform

Datasets curados para treinamento, feature-ready e compatíveis com MLflow. Pipelines de preparação de dados orientados a workloads de Machine Learning e IA generativa.

Confiabilidade & Escala

Replay handling, deduplicação, grain validation e surrogate keys determinísticas. Orquestração DAG serverless ponta a ponta com Databricks Jobs — escalável sem overhead operacional.

Plataforma operacional com governança end-to-end
Analytics e ML habilitados em produção
Observabilidade total do ciclo de vida dos dados
Arquitetura escalável e AI-ready
Zero dependência de FileStorage legado
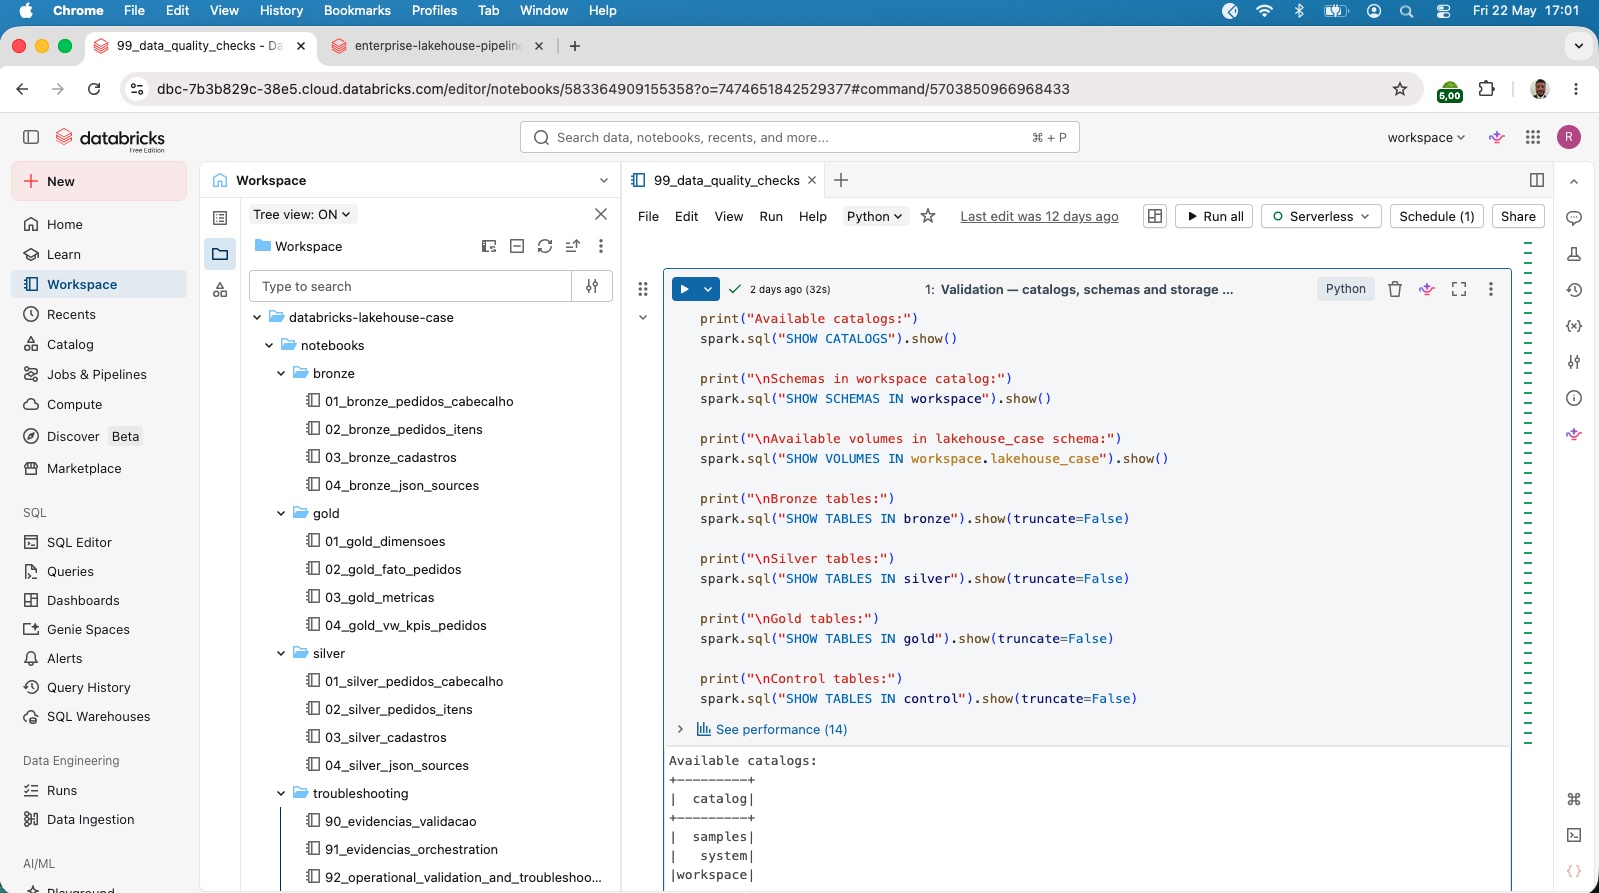
Workspace · Estrutura do projeto

Notebooks organizados por camada — Bronze · Silver · Gold · Troubleshooting

Estrutura de pastas enterprise com notebooks numerados, orchestration YAML e data quality checks operacionais.

Databricks Workspace — estrutura de notebooks por camada Lakehouse
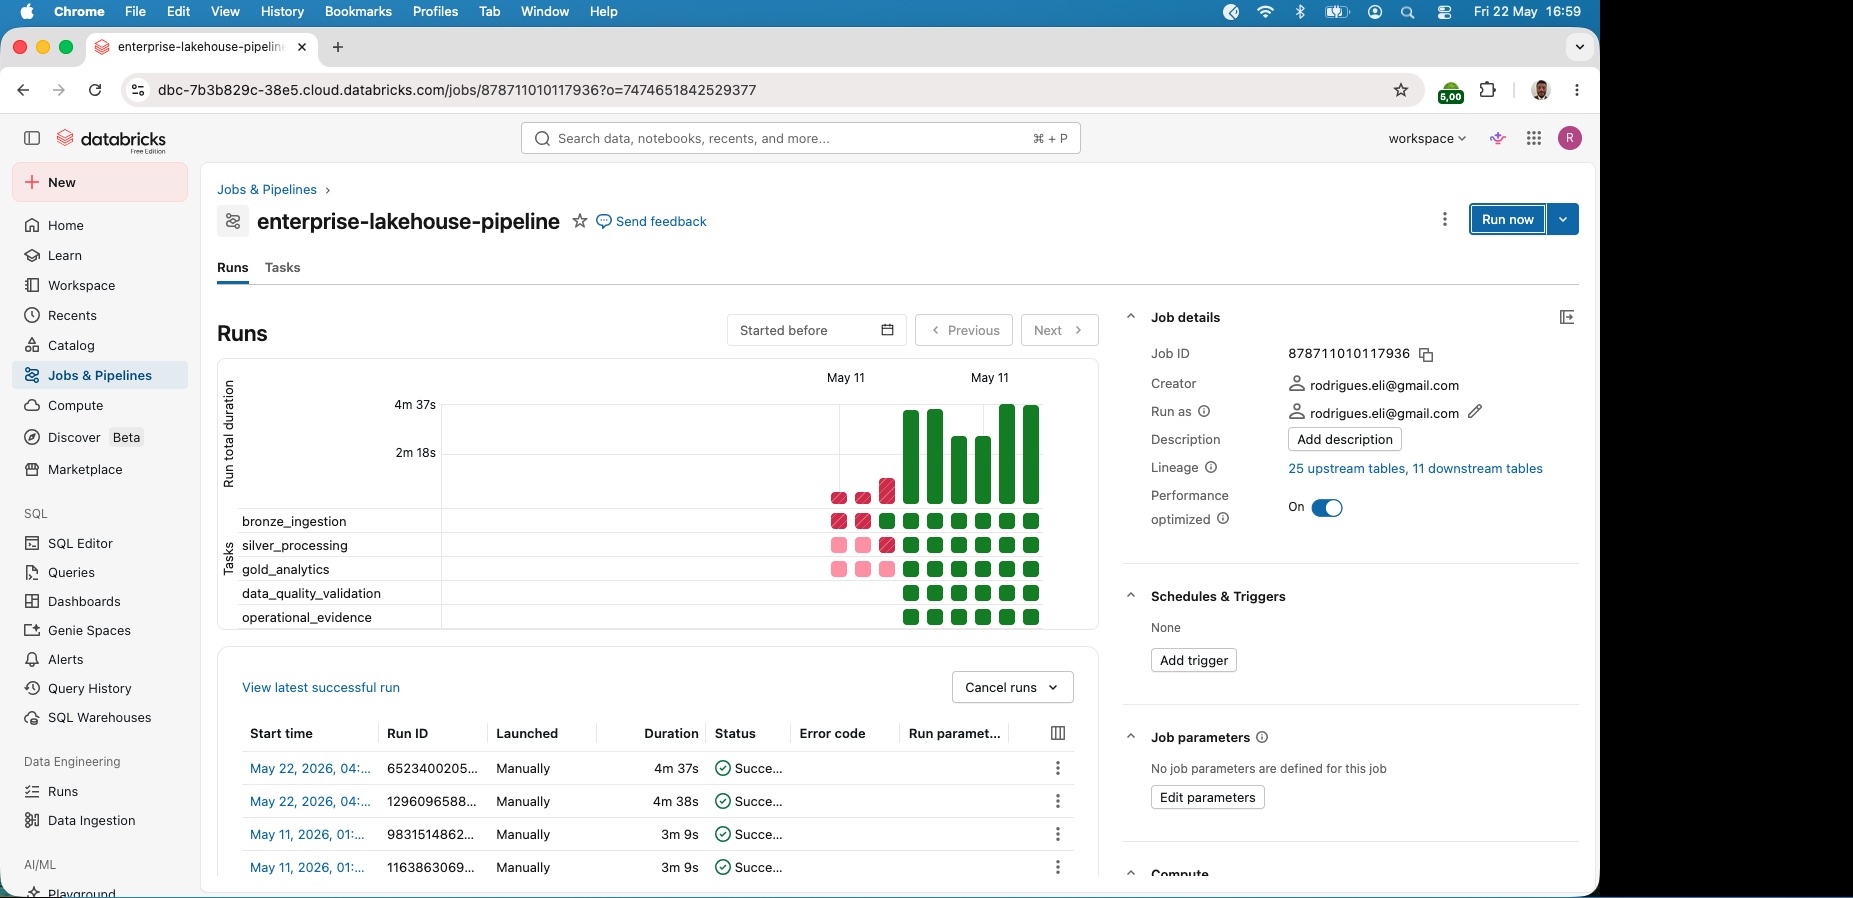
Jobs & Pipelines · Execuções

enterprise-lakehouse-pipeline — DAG serverless com 5 tasks e histórico de execuções

bronze_ingestion → silver_processing → gold_analytics → data_quality_validation → operational_evidence · 25 upstream / 11 downstream tables · Serverless compute.

Databricks Jobs — pipeline enterprise com DAG e histórico de execuções bem-sucedidas

Projeto desenvolvido com foco em práticas de engenharia de dados corporativa, incluindo orquestração serverless, observabilidade operacional, governança de pipelines, data quality validation e troubleshooting operacional em arquitetura Lakehouse.

Da ingestão ao insight · Lakehouse · Multi-cloud (Azure · AWS · GCP)

Processamento Distribuído

PySpark Apache Spark Delta Lake Batch & Streaming Auto Loader Streaming Tables AWS Glue (Spark) Kinesis (Streaming) Apache Kafka Event-Driven Architecture Streaming Data Pipelines Near Real-Time Processing

Cloud & Lakehouse

Azure Databricks ADLS Gen2 AWS/GCP Unity Catalog AWS (Glue, Kinesis, Redshift, S3) BigQuery Dataproc Cloud Storage Dataflow Cloud Composer

Orquestração

Airflow ADF Databricks Workflows Databricks Asset Bundles AWS Step Functions AWS Glue Workflows MWAA (Airflow AWS)

GenAI · RAG · AI-ready Data

GenAI RAG Embeddings Chunking Semantic Search Vector Search AI Governance Data Products

Machine Learning

Python (Pandas/NumPy) Scikit-learn NLP Visão Computacional

Governança, Qualidade & Regulatório

Unity Catalog Data Lineage RBAC Delta Lake BACEN Auditoria Conformidade

Integração de dados

APIs Streaming Arquivos Sistemas legados Lakeflow Connect Data Ingestion AWS Kinesis AWS S3

Entregas de alto impacto

Pipelines distribuídos

Processamento de grandes volumes de dados com PySpark e arquitetura escalável.

Lakehouse em produção

Implementação Bronze → Silver → Gold com Delta Lake e governança Unity Catalog.

Dados para modelos ML

Preparação e organização de datasets para treinamento, NLP e visão computacional.

Automação & orquestração

Airflow, Azure Data Factory, Databricks Workflows para pipelines confiáveis.

Integração de fontes

APIs, streaming, arquivos e sistemas legados em um só ecossistema.

Otimização performance/custos

Melhorias contínuas em cloud (Azure/AWS/GCP) e eficiência de processamento.

Redução de 30h+ para ~2h30 em pipeline crítico

Redesign arquitetural de pipeline com Spark tuning, estratégia de particionamento, otimização de SQL, processamento incremental — eliminando reprocessamento full-scan em ambiente de produção.

Experiência com dados em escala

MAR 2026 — ATUAL
Senior Data Engineer
PSW · Consultoria · Disponível para alocação

Implementação e evolução de pipelines de dados em arquitetura Lakehouse com Azure Databricks, PySpark, SQL e Delta Lake, incluindo tratamento, padronização, validação e disponibilização de dados em camadas analíticas.

GenAI · RAG · AI-ready Data Construção da fundação de dados para aplicações GenAI/RAG: ingestão e curadoria de documentos, chunking, embeddings, busca semântica com rastreabilidade das fontes, auditoria de execução e controle de nível de sensibilidade. Arquitetura reproduzida em case público, sem dados do cliente.
MAI 2022 — MAR 2026
Senior Data Engineer
Semantix · Consultoria em dados · Alocações em clientes (Remoto)

Atuação em plataformas de dados Lakehouse com Azure Databricks em clientes dos setores de seguros e serviços financeiros, do provisionamento da infraestrutura à estabilização em produção.

Lifetime Tech DEZ 2025 — MAR 2026
Atuação como Head of Data Engineering no cliente
  • Provisionamento da plataforma de dados Azure do zero em DEV, PRE-PRD e PRD: ADLS Gen2, Databricks Premium, Unity Catalog, Key Vault, Access Connector e RBAC
  • Pipeline de dados não estruturados (áudio → texto) em arquitetura Medalhão orquestrada por ADF: diarização, enriquecimento com dados de CRM, classificação, sumarização e entrega via API corporativa
  • Controle de estado por sessão, jobs agendados com Databricks Asset Bundles e dashboard operacional de monitoramento
  • Estabilização em produção: correções de detecção de ambiente, schema evolution na Silver e column mapping no Delta Lake, reduzindo a fila pendente de ~83 para 3 sessões
  • Pipeline de receita e comissionamento com carga de 1,5M+ registros em Azure SQL via JDBC, com tuning de paralelismo e modos de carga inicial e incremental
Projeto de destaque — pipeline áudio → texto Plataforma ponta a ponta de dados não estruturados para análises e NLP, com rastreabilidade por sessão do Bronze ao Gold e integração com sistemas corporativos para tomada de decisão.
Bradesco Seguros · Open Insurance (OPIN) NOV 2022 — DEZ 2025
Senior Data Engineer
  • Pipelines PySpark para ingestão e transformação de dados
  • Arquitetura Bronze/Silver/Gold com Delta Lake
  • Preparação de dados para consumo analítico e suporte a modelos de ML
  • Orquestração com Azure Data Factory + Databricks Workflows
  • Integração com APIs, arquivos e sistemas corporativos, governança Unity Catalog
OUT 2021 — NOV 2022
Data Engineer
DataSide · Projetos diversos (Google Cloud)

Desenvolvimento de pipelines distribuídos batch e streaming em Google Cloud Platform, com foco em performance, escalabilidade e otimização de custos em workloads analíticos de alto volume.

  • Pipelines distribuídos com Dataproc (PySpark) para processamento em larga escala — particionamento, processamento incremental e tuning de performance Spark
  • Ingestão e transformação de dados em BigQuery com modelagem analítica orientada a consumo enterprise de BI e otimização de queries distribuídas
  • Arquitetura de storage e staging em Cloud Storage com controle de ingestão, rastreabilidade e integração com Cloud Composer (Airflow) e Dataflow
  • Estruturação de datasets analíticos escaláveis para times de Analytics e Data Science
  • Otimização contínua de performance de workloads distribuídos e eficiência de custos em GCP
MAI 2019 — OUT 2021
Data Engineer — AWS Platform
DataSide · Projeto Santander (AWS)

Engenharia de plataforma de dados distribuída em ambiente AWS cloud-native para workloads analíticos críticos do setor financeiro — alto volume de eventos, processamento near real-time e requisitos rigorosos de rastreabilidade, auditabilidade e conformidade operacional.

  • Arquitetura e implementação de pipelines distribuídos com AWS Glue (PySpark) para processamento em larga escala de eventos financeiros em ambiente serverless — incluindo estratégia de particionamento, processamento incremental e schema evolution
  • Ingestão contínua de alto volume de eventos financeiros via Amazon Kinesis com arquitetura resiliente — event-driven ingestion, retry strategy, tolerância a falhas e garantias de entrega para workloads near real-time
  • Modelagem dimensional e otimização analítica em Redshift e Snowflake — schemas orientados a consumo enterprise de BI, tuning de queries analíticas e suporte a cargas distribuídas de alta demanda
  • Implementação de replay handling, deduplicação, controle de idempotência e padrões CDC em pipelines distribuídos críticos para garantia de consistência e conformidade de dados financeiros
  • Orquestração de workflows mission-critical com AWS Glue Workflows e Step Functions — controle de dependências, rastreabilidade operacional, reprocessamento seguro e gestão de falhas com evidência auditável
  • Observabilidade operacional com logging centralizado, monitoramento de execuções e troubleshooting de pipelines fault-tolerant em ambiente regulatório financeiro
  • Integração multi-fonte via APIs, S3 e sistemas transacionais corporativos com controle de ingestão e rastreabilidade end-to-end
  • Otimização de performance Spark e custos de workloads distribuídos em arquitetura cloud-native AWS — ajuste de recursos, compressão de dados e eficiência operacional contínua
Technical Highlight — AWS Streaming Data Platform Arquitetura distribuída AWS baseada em Amazon Kinesis + AWS Glue PySpark para ingestão contínua de alto volume de eventos financeiros, suportando workloads near real-time com replay handling, deduplicação, observabilidade operacional, fault-tolerant streaming e processamento distribuído resiliente em ambiente regulatório crítico.
OUT 2018 — MAI 2019
Machine Learning Engineer / Data Engineer
InCor — Instituto do Coração (USP) · São Paulo

Atuação em projeto de inteligência artificial aplicada à saúde, com foco em análise de imagens médicas e apoio à decisão clínica em ambiente hospitalar de alta criticidade.

  • Desenvolvimento de pipelines de Machine Learning e preparação de dados para treinamento e inferência
  • Construção de modelos de visão computacional para análise de radiografias e identificação de padrões cardíacos
  • Utilização de Python, TensorFlow e PyTorch para treinamento, avaliação e otimização de modelos
  • Estruturação de pipelines para processamento de imagens médicas e datasets em larga escala
  • Implementação de práticas de monitoramento, versionamento e automação do ciclo de vida dos modelos (MLOps)
  • Apoio técnico às equipes multidisciplinares na utilização de modelos analíticos para suporte ao diagnóstico médico
Projeto de destaque — IA aplicada à saúde Desenvolvimento de solução de visão computacional para apoio ao diagnóstico médico com processamento de imagens radiológicas, classificação de padrões cardíacos e pipelines de treinamento automatizados.

Construído em produção. ML e dados.

01 · SEMANTIX · LIFETIME TECH
Pipeline Áudio → Texto + NLP
Pipeline end-to-end de dados não estruturados: gravações de áudio convertidas em texto com diarização, enriquecimento com dados de CRM, classificação, sumarização e entrega via API corporativa. Arquitetura Medalhão em Azure Databricks orquestrada por ADF, com controle de estado por sessão e governança Unity Catalog.
PySparkAzure DatabricksADFNLPDelta LakeUnity Catalog
02 · INCOR / USP
IA aplicada à análise de imagens médicas
Desenvolvimento de plataforma de visão computacional para apoio à análise de radiografias em ambiente hospitalar crítico. Construção de pipelines de treinamento e inferência utilizando TensorFlow/PyTorch, preparação de datasets médicos, classificação de padrões cardíacos e automação do ciclo de vida dos modelos. Atuação em processamento de imagens médicas, monitoramento de modelos e estruturação de pipelines orientados a MLOps.
TensorFlowPyTorchComputer VisionMLOpsPythonMachine Learning
03 · ECOSSISTEMA MULTICLOUD
Plataforma Lakehouse para Analytics & AI
Construção de arquitetura Lakehouse escalável em Azure e AWS utilizando Databricks, PySpark, Delta Lake e Unity Catalog. Implementação de pipelines distribuídos para ingestão, transformação e disponibilização de dados analíticos para times de BI, Data Science e Machine Learning. Atuação em governança, otimização de performance, integração multi-fonte e preparação de datasets para workloads analíticos e IA.
DatabricksPySparkDelta LakeUnity CatalogLakehouseMachine Learning

Lakehouse corporativo · GenAI · Databricks · PySpark · Delta Lake

Projetos autorais publicados no GitHub, demonstrando arquitetura Lakehouse com governança operacional, observabilidade de pipelines e fundação de dados para GenAI/RAG.

01 · PROJETO TÉCNICO AUTORAL
Databricks Lakehouse Case
Arquitetura Lakehouse corporativa ponta a ponta utilizando Databricks, PySpark e Delta Lake com orquestração serverless, quality framework operacional, semantic layer analítica, replay handling, observabilidade de pipelines e governança operacional baseada em DAG.
Destaques técnicos
Arquitetura Medalhão Bronze / Silver / Gold
Ingestion Log operacional com auditoria de carga
Quality Log centralizado para troubleshooting
Replay handling e prevenção de duplicidade
Enforcement de granularidade (grain validation)
Surrogate keys determinísticas
Semantic Layer analítica
Views executivas para BI
Tratamento de dados órfãos
Pipeline observável e rastreável
Orquestração ponta a ponta com Databricks Jobs
DAG serverless com dependência entre camadas
Data Quality Validation automatizado
Framework operacional de troubleshooting
Evidências documentadas de execução Databricks
Desafios resolvidos
Correção de replay/deduplicação em cargas incrementais
Tratamento de status inconsistentes
Normalização de chaves dimensionais
Identificação de registros órfãos
Garantia de grain único na fato
Rastreabilidade completa de falhas
Troubleshooting operacional com evidências documentadas
Orquestração & Operação
Pipeline Bronze → Silver → Gold orquestrado
Databricks Jobs com DAG orientado a dependências
Execução serverless ponta a ponta
Data Quality Validation integrado ao pipeline
Observabilidade operacional da execução
Logs centralizados de ingestão e qualidade
Execução rastreável com troubleshooting operacional
Databricks PySpark Delta Lake Lakehouse Data Governance Semantic Layer Quality Framework Observability Replay Handling Data Quality Auditing Databricks Jobs DAG Orchestration Serverless Pipeline Monitoring Data Lineage

Projeto desenvolvido com foco em práticas de engenharia de dados corporativa, incluindo orquestração serverless, observabilidade operacional, governança de pipelines, data quality validation e troubleshooting operacional em arquitetura Lakehouse.

02 · PROJETO TÉCNICO AUTORAL
Databricks GenAI RAG Lakehouse Case
Case técnico de Engenharia de Dados para IA Generativa, demonstrando uma arquitetura Lakehouse orientada a Databricks com ingestão de documentos, camadas Bronze/Silver/Gold, qualidade de dados, chunking, embeddings, busca semântica, consulta RAG, auditoria e rastreabilidade.
Destaques técnicos
Ingestão de documentos com metadados operacionais
Arquitetura Lakehouse Bronze / Silver / Gold
Data Quality aplicado antes da camada Gold
Chunking de documentos para recuperação semântica
Embeddings e índice vetorial simplificado
Busca semântica com score e fontes recuperadas
Consulta RAG com referência ao documento de origem
Auditoria de execução em eventos JSONL
Controle de nível de sensibilidade por documento
Documentação de governança, lineage e contrato de dados
Valor demonstrado
Fundação de dados confiável para aplicações GenAI
Dados preparados, governados e rastreáveis para RAG
Separação entre engenharia de dados, busca semântica e consumo por IA
Governança aplicada a dados usados por soluções inteligentes
Databricks PySpark Lakehouse Bronze/Silver/Gold GenAI RAG Embeddings Semantic Search Data Governance Data Quality Data Lineage Auditability

Projeto desenvolvido para evidenciar como um Engenheiro de Dados prepara dados corporativos para GenAI: ingestão, qualidade, governança, rastreabilidade, semantic search e consulta RAG com fontes auditáveis.

03 · PROJETO TÉCNICO AUTORAL · EM DESENVOLVIMENTO
dbt + Databricks Lakehouse Case
Projeto autoral de estudo sobre o uso de dbt com Databricks para transformações analíticas em SQL. Explora a separação de responsabilidades entre a engenharia de dados da plataforma Lakehouse e a modelagem analítica com dbt, com foco em organização, manutenibilidade e evolução das transformações.
Objetivos do case
Integração de conceitos de dbt e Databricks
Transformações analíticas orientadas a SQL
Organização e manutenção de modelos de dados
Evolução de um projeto Lakehouse para Analytics Engineering
dbt Databricks SQL Lakehouse Analytics Engineering Projeto em desenvolvimento

Case de portfólio em desenvolvimento. O código está disponível no GitHub; execução no workspace Databricks, testes e implantação ainda não foram verificados nesta revisão.

Ferramentas, clouds e certificações

Data Engineering · Core
Python PySpark Apache Spark Delta Lake SQL Scala Hadoop/Hive Kafka Airflow Docker/K8s
Cloud · Azure · AWS · GCP
Azure Databricks ADLS Gen2 Microsoft Fabric Azure Data Factory Unity Catalog AWS Analytics Stack AWS Glue Kinesis Redshift BigQuery Dataproc Snowflake
Machine Learning & Data Science
Pandas/NumPy Scikit-learn Preparação de dados NLP Visão computacional Classificação/Detecção
GenAI · RAG · AI-ready Data
GenAI RAG Embeddings Semantic Search Vector Search Data Products AI Governance
Streaming & Event-Driven
Apache Kafka AWS Kinesis CDC Event-Driven Architecture Streaming Data Pipelines Near Real-Time Processing
Banco de dados
Oracle PostgreSQL MySQL SQL Server MongoDB Snowflake
Certificações & especializações
Data Engineering — Udacity Especialização Data Science Machine Learning Big Data Databricks Academy – Data Ingestion Databricks Academy – DevOps Essentials for Data Engineering Microsoft Fabric – Programação e Análise de Dados (2026) AWS Cloud Practitioner (CLF-C01) – Curso preparatório Apache Kafka e Databricks: Streaming e Processamento (Udemy – 2026)

Vamos modernizar sua plataforma de dados?

Disponível para projetos de transformação de plataformas analíticas, arquitetura Lakehouse enterprise, modernização de dados legados, fundação de dados para GenAI e engenharia de plataforma em Azure/AWS/GCP. Entre em contato para uma conversa estratégica.


Itupeva, SP — Remoto